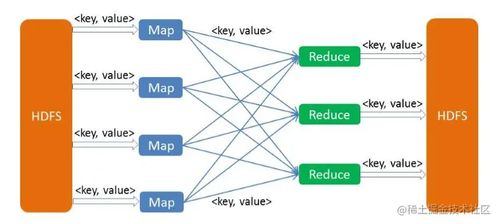
在當(dāng)今數(shù)據(jù)爆炸的時(shí)代,MapReduce作為大數(shù)據(jù)處理領(lǐng)域的奠基性分布式計(jì)算模型,自Google提出以來,深刻影響了Hadoop、Spark等生態(tài)系統(tǒng)的設(shè)計(jì)與演進(jìn)。本文將從核心原理、工作機(jī)制、經(jīng)典應(yīng)用案例三個(gè)維度,帶您深入理解MapR再uce的本質(zhì)與實(shí)務(wù)價(jià)值。\n\n一、核心原理:分而治之的思想\nMapReduce源自函數(shù)式編程中的map(映射)與reduce(歸約)操作。在處理大數(shù)據(jù)時(shí),它的設(shè)計(jì)哲學(xué)是自動(dòng)將海量數(shù)據(jù)劃分為獨(dú)立的分片(split),并在集群的多個(gè)節(jié)點(diǎn)上并行執(zhí)行兩種類型的任務(wù):\n1. Map階段\n每個(gè)算子代理分配到一個(gè)InputSplit切片后,逐步解析記錄(如與CSV行對(duì)應(yīng)),應(yīng)用用戶定義的映射函數(shù),輸出若干
MapReduce詳解 大數(shù)據(jù)處理經(jīng)典框架的深度剖析與應(yīng)用指南
如若轉(zhuǎn)載,請(qǐng)注明出處:http://www.wearapp.com.cn/product/102.html
更新時(shí)間:2026-11-04 17:49:56
產(chǎn)品列表
PRODUCT
----------------